行业资讯
大数据之数据建模
建模无疑是大数据里面最艺术的部分,也是最令大数据从业者痴迷、得意的领域,一个好的模型就是一篇作品,是一首诗,令人心旷神怡。下面浅谈关于数据建模: 一、建模并不神秘:让数据产生新的数据 一些建模的观点已在前面的道与法两篇体现,归纳如下: 建模的本质就是让数据产生新的数据。 人类、智能体的认知、行动需要用到不同的数据(Know->行动),如果这个数据没有被直接掌握,那就要基于已知的事实数据推测…
手把手一步一步教你做“词云图”
开篇介绍 我们经常在各个媒体,微信圈,个人博客看到类似于这样的图片。第一感觉就是很漂亮,接着就在想这个东西是怎么做到的,觉得非常有意思。与以往相比,这些图片上要表达和突出重点的方式很特别。比如通过地图,人物来突出一些重点,关键词,这种表达方式是非常新颖也是非常有个性的。 我也简单的用我的ID- BIWORK 制作了几个 Logo 分享一下,非常快一分钟就可以完成。 或者人头像都可以的,下图为我不…
三种可以在SAS里调用R的方法
坊间关于SAS和R以及其他各种工具的比较和争论已经很多了,本文在此不再赘述。我们今天聊一聊一个更实际的问题:如何在SAS里调用R? 如何在SAS里调用R?简单来说,目前我知道的有三种方式,具体如下: 1.SAS/IML interface 2.%Proc_R 3.Base SAS Java Object 这三种方式,在使用方式、易用性以及稳定性上都有差别。第一种是借助SAS 的IML过程调用R;…
如何优雅的进行表结构设计
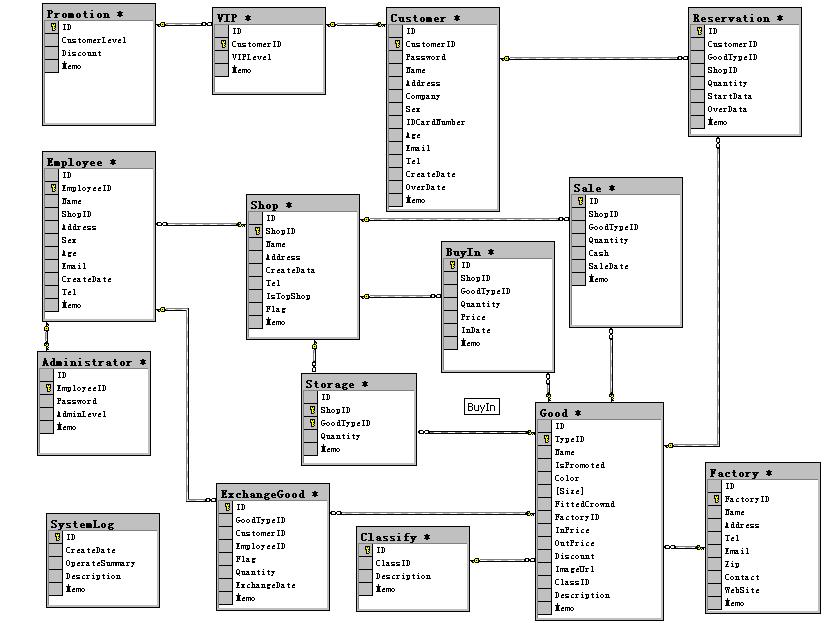
数据库表结构设计作为后端软件开发不可或缺的一环,是每个后端工程师都会经历的过程。笔者也多次经历过这样的过程,也尝试过多种不同的设计方案,也从一些优秀的框架中学到不少,但并没有发现相关的文章对其进行总结。所以本文尝试把笔者看到的、学到的总结下来,希望对阅读本文的读者有所启发。表结构设计主要有两个目的,一是让表结构更加的更具有表现力,做到数据库表的自描述,减少注释甚至不使用注释;二是满足系统效率和扩…

比较一下Spark的三种集群部署模式
Spark有三种集群部署模式,或者叫做集群管理模式。分别是standalone,YARN和Mesos。这三种模式其实都是master/slave模式。 那么在实际的项目中,我们该如何对比选择呢?下面是我的一些总结,主要参考了: Which Apache Spark Cluster Managers Are The Right Fit? YARN, Mesos, or Standalone? 三种…
Java分布式缓存框架 TOP 5
在开发中大型Java软件项目时,很多Java架构师都会遇到数据库读写瓶颈,如果你在系统架构时并没有将缓存策略考虑进去,或者并没有选择更优的缓存策略,那么到时候重构起来将会是一个噩梦。本文主要是分享了5个常用的Java分布式缓存框架,这些缓存框架支持多台服务器的缓存读写功能,可以让你的缓存系统更容易扩展。 1、Ehcache – Java分布式缓存框架 Ehcache是一个Java实现的开源分布式…
大数据工程师技能图谱
大数据通用处理平台 Spark Flink Hadoop 分布式存储 HDFS 资源调度 Yarn Mesos 机器学习工具 Mahout Spark Mlib TensorFlow (Google 系) Amazon Machine Learning DMTK (微软分布式机器学习工具) 数据分析/数据仓库(SQL类) Pig Hive kylin Spark SQL, Spark DataF…
如何创建一个大数据平台?
整体而言,大数据平台从平台部署和数据分析过程可分为如下几步: 1、linux系统安装 一般使用开源版的Redhat系统--CentOS作为底层平台。为了提供稳定的硬件基础,在给硬盘做RAID和挂载数据存储节点的时,需要按情况配置。例如,可以选择给HDFS的namenode做RAID2以提高其稳定性,将数据存储与操作系统分别放置在不同硬盘上,以确保操作系统的正常运行。 2、分布式计算平台/组件安装…
R语言:缺失值的处理
缺失值在数据分析和数据挖掘领域里面是进场碰到的,而且对我们的数据处理来说很重要,稍有不甚,便对我们的模型有很大的影响,因此,对于数据的处理,我们需要合适的方法. 一.什么是缺失值,NA与NULL的区别 (1)NA表示数据集中的该数据遗失、不存在。在针对具有NA的数据集进行函数操作的时候,该NA不会被直接剔除。如x<-c(1,2,3,NA,4),取mean(x),则结果为NA,如果想去除NA…

数据分析方法分享
1 数据分析前,我们需要思考 像一场战役的总指挥影响着整个战役的胜败一样,数据分析师的思想对于整体分析思路,甚至分析结果都有着关键性的作用。 2 分析问题和解决问题的思路 ❶ 定义问题(重要步骤之一): 1)首先,要搞清楚问题的实质,准确、完整、真实地表达问题。 2)其次,弄清楚为什么要解决这个问题? 3)最后,解决这个问题的意义何在?是必须解决还是无关紧要,或是需要马上解决这个问题还是不太着急…