行业资讯
数据仓库的多维数据模型
可能很多人理解的数据仓库就是基于多维数据模型构建,用于OLAP的数据平台,通过上一篇文章——数据仓库的基本架构,我们已经看到数据仓库的应用可能远不止这些。但不得不承认多维数据模型是数据仓库的一大特点,也是数据仓库应用和实现的一个重要的方面,通过在数据的组织和存储上的优化,使其更适用于分析型的数据查询和获取。 多维数据模型的定义和作用 多维数据模型是为了满足用户从多角度多层次进行数据查询和分析的需…
一个Spark缓存的使用示例
之前一直不是非常理解Spark的缓存应该如何使用。今天在使用的时候,为了提高性能,尝试使用了一下Cache,并收到了明显的效果。关于Cache的一些理论介绍,网上已经很多了。但是貌似也没有一个简单的例子说明。 注: 因为使用的是内部数据文件, 在这边就不公布出来了。大家看看测试代码跟测试结果即可。这次测试是在JupyterNotebook这种交互式的环境下测试的。如果是直接的submit一个jo…
你应该使用NoSQL数据库、SQL数据库还是两者都用?
SQL和NoSQL之争只不过是关系数据库和非关系数据库的比较。区别在于它们是如何构建的、存储信息的种类以及如何存储信息。关系数据库是结构化的,非关系数据库是面向文档、分布式的。四十多年来,结构化查询语言(SQL)数据库一直是主要的数据存储机制。 随着Web应用程序以及PostgreSQL、MySQL和SQLite等开源技术日益盛行,使用率在上世纪90年代末急剧提高。尽管NoSQL数据库自上世纪6…
云时代:数据中心如何迁移?这里有7个步骤
当谈到云迁移时,你是哪种人?是早早地跳上“云的火车”,还是没有试图虚拟化任何东西的落后者?也或者你仍处于主流之中,在本地上采用混合的云和一些系统呢? 在我们的云迁移实践中,我们发现每种类型都面临自己的挑战。早期的采用者无法支持它们有雄心的部署,并且发现了第一代云系统的弱点。落后者可能意识到转型的必要性,但是却受阻于成本、资源和时间。大多数的企业仍是主流,它们往往采用一种混合IT策略,但是却在管理…
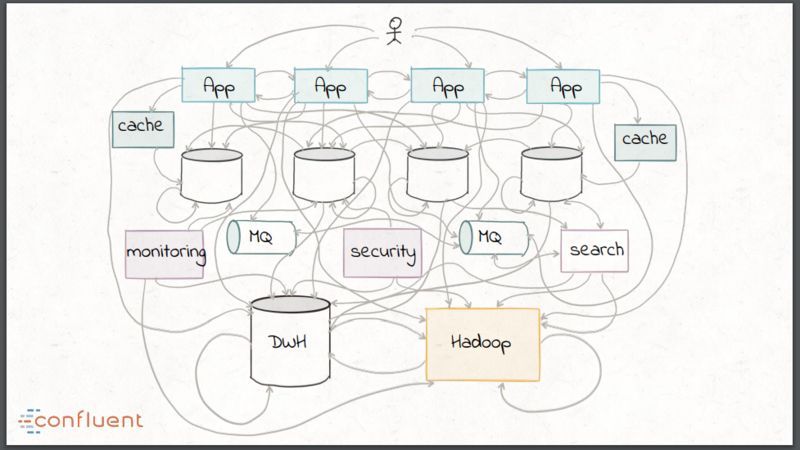
批处理ETL已死,Kafka才是数据处理的未来?
在 QCon 旧金山会议上,Neha Narkhede 做了“ETL 已死,而实时流长存”的演讲,并讨论了企业级数据处理领域所面临的挑战。该演讲的核心前提是开源的 Apache Kafka 流处理平台能够提供灵活且统一的框架,支持数据转换和处理的现代需求。 Narkhede 是 Confluent 的联合创始人和 CTO,在演讲中,他首先阐述了在过去的十年间,数据和数据系统的重要变化。该领域的传…
如何将一个数据库中的一个表复制到另一个数据库的表中去
第一种情况: 将a数据库.dbo.a表的数据追加到b数据库.dbo.b表中 (条件:此时b数据库中已创建好了b表) inert into b数据库.dbo.b表 select * from a数据库.dbo.a表 [where 条件] 此T-SQL语句会有异常 仅当使用了列列表并且 IDENTITY_INSERT 为 ON 时,才能为表'b数据库.dbo.b表'中的标识列指定显式值。 原因:b数…
了解这些大数据和算法,让你终生受益!
本篇总结一下自己对大数据算法认知的过程。正文包含两部分:自己对算法的认知过程和对大数据算法的理解。写这篇博客的原因有很多,总的来讲有下面几点:自己在算法的路上一直懵懵懂懂,现在刚刚有了一点点头绪,赶快做个记录。梳理清楚自己的思路,后续会有一个算法学习的一到两年的计划,这算是个引子。谈起算法大家都只会想到经典算法和机器算法,除此之外还有很多有意思的算法,特别是为了解决大数据量问题的算法,这些很容易…
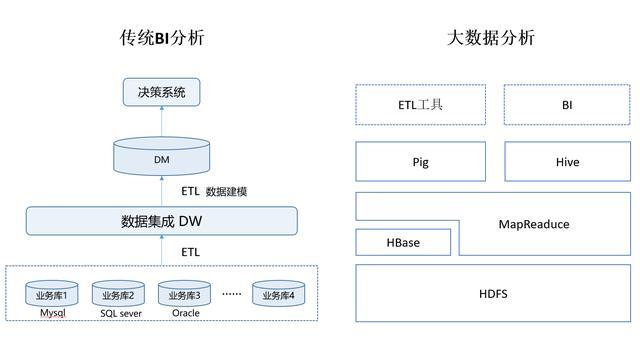
大数据和BI商业智能有何区别?有何相关?
大数据 ≠BI商业智能,大数据也不是传统商业智能的简单升级。 1、大数据和BI两者的区别 BI(BusinessIntelligence)即商业智能,它是企业数据化管理的一整套的方案,用来将企业中现有的数据进行有效的整合,快速准确的提供报表并提出决策依据,帮助企业做出明智的业务经营决策,解决的是管理运营战略的问题。 大数据(Big Data)是指在可承受的时间范围内用常规软件工具进行捕捉、管理和…
数据泄露事故诉讼:企业应该怎么做?
数据泄露事故是给企业带来持续影响的商业危机。当发现有数据泄露事故发生时,企业应该调查发生了什么事情、修复安全漏洞、配合执法部门工作以及遵守通知法规,认真遵循这些步骤可帮助企业减少影响。同时,面对数据泄露事故的企业还需要关注后续的诉讼。 这里的诉讼可能是政府执法部门诉讼的形式,也可能是来自雇员、消费者或第三方的私人诉讼形式。本文中我们将探讨企业可能面临的数据泄露诉讼类型、其中涉及哪些法律理论以及可…
大数据处理为何选择Spark,而不是Hadoop
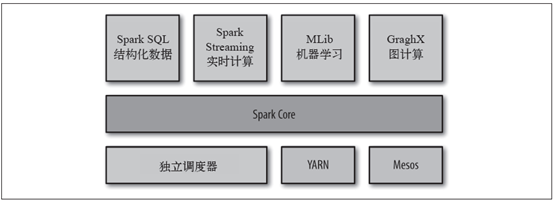
Spark是一个用来实现快速而通用的集群计算的平台。在速度方面,Spark扩展了广泛使用的MapReduce计算模型,而且高效地支持更多计算模式,包括交互式查询和流处理。 一、基础知识 1.Spark Spark是一个用来实现快速而通用的集群计算的平台。在速度方面,Spark扩展了广泛使用的MapReduce计算模型,而且高效地支持更多计算模式,包括交互式查询和流处理。 Spark项目包含多个紧…